Transformer des données de vente en groupes exploitables
Une étude comparative de méthodes de clustering et de recherche de motifs fréquents pour construire une démarche de recommandation produit.
- Contexte
- Projet réalisé dans le cadre de ma formation supérieure
- Rôle
- Cadrage, analyse, expérimentation et restitution
- Statut
- Terminé
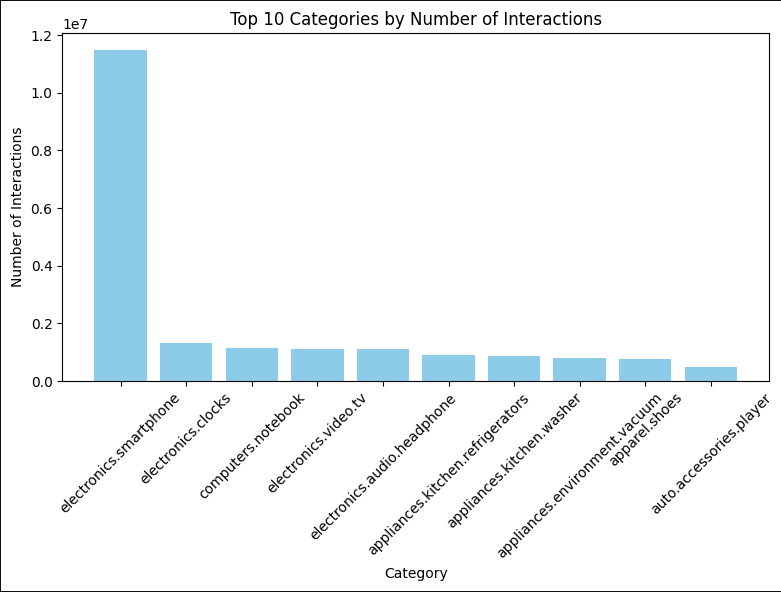
- Donnée → groupes → recommandations
- Plusieurs méthodes comparées
- Hypothèses et limites documentées
Passer de données brutes à une décision explicable.
Problématique
Des données de vente brutes ne deviennent pas spontanément une recommandation utile. Il fallait d’abord établir une base d’analyse fiable, comparer des méthodes de regroupement puis relier les groupes obtenus à des associations de produits compréhensibles.
Mission
Définir la démarche, préparer les données, expérimenter plusieurs algorithmes et produire une restitution permettant d’expliquer les choix autant que les résultats.
Comparer avant de conclure.
- 01
Cadrer et préparer
Rédaction du cahier des charges et de la note de cadrage, puis nettoyage, sélection et transformation des variables utiles à l’analyse.
- 02
Comparer les regroupements
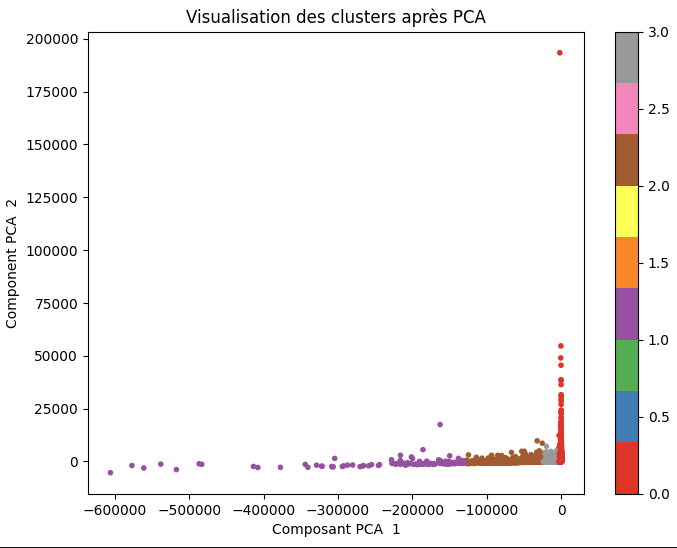
Expérimentation de K-means et DBSCAN, observation de la structure des groupes et visualisation des écarts entre les approches.
- 03
Relier groupes et produits
Recherche de motifs fréquents avec Apriori afin de faire émerger des associations de produits et une logique de recommandation par groupe.
- 04
Rendre la démarche vérifiable
Création de graphiques et rédaction d’un rapport de soutenance pour documenter les hypothèses, limites et résultats observés.
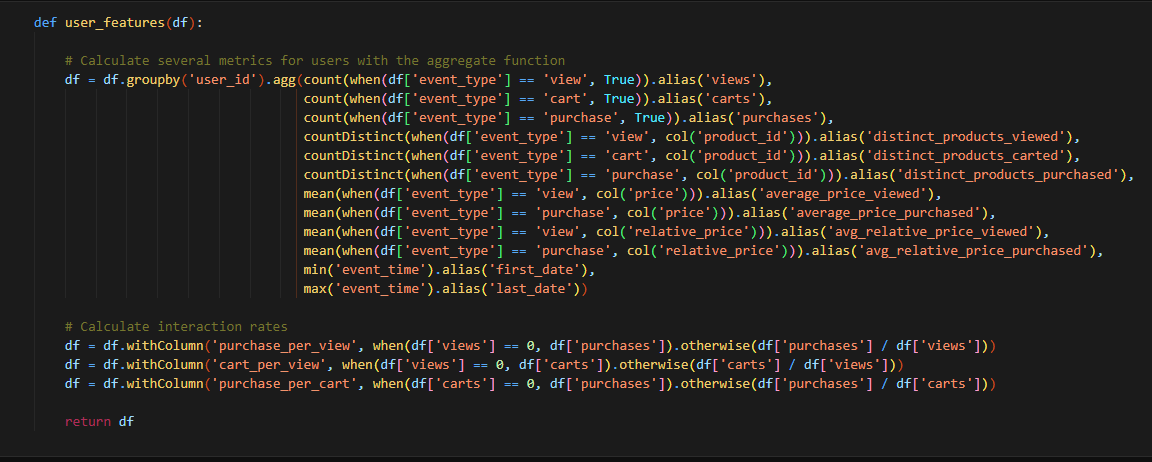
Un résultat utile parce qu’il reste lisible.
Ce projet m’a surtout appris qu’un résultat de machine learning n’a de valeur que s’il peut être expliqué, relié à une décision et présenté avec ses limites. La préparation des données et la qualité de la restitution pèsent autant que le choix de l’algorithme.
- Une chaîne d’analyse structurée depuis la donnée brute jusqu’à la recommandation.
- Une comparaison argumentée de plusieurs méthodes plutôt qu’un algorithme choisi par défaut.
- Des visualisations facilitant la lecture des groupes et la restitution du travail.
- Une documentation de cadrage et de soutenance réutilisable pour expliquer les décisions.